骁龙 X2 Elite 架构解析:18核芯片... — Analysis
据 Chips and Cheese 于 2026 年 9 月 29 日发布的深度技术拆解报告,高通最新旗舰笔记本芯片骁龙 X2 Elite Extreme 凭借 18 个 CPU 核心与接近 NVIDIA GeForce GTX 1070 Ti 算力的集成 GPU,成为近年来笔记本处理器市场最激进的入场者之一。报告指出,要在如此紧凑的芯片面积内同时满足 CPU、GPU 与内存子系统的高带宽需求,系统级互连架构的设计难度已远超以往任何一代移动处理器。
花边爆料群集化设计:高通简化互连的关键策略
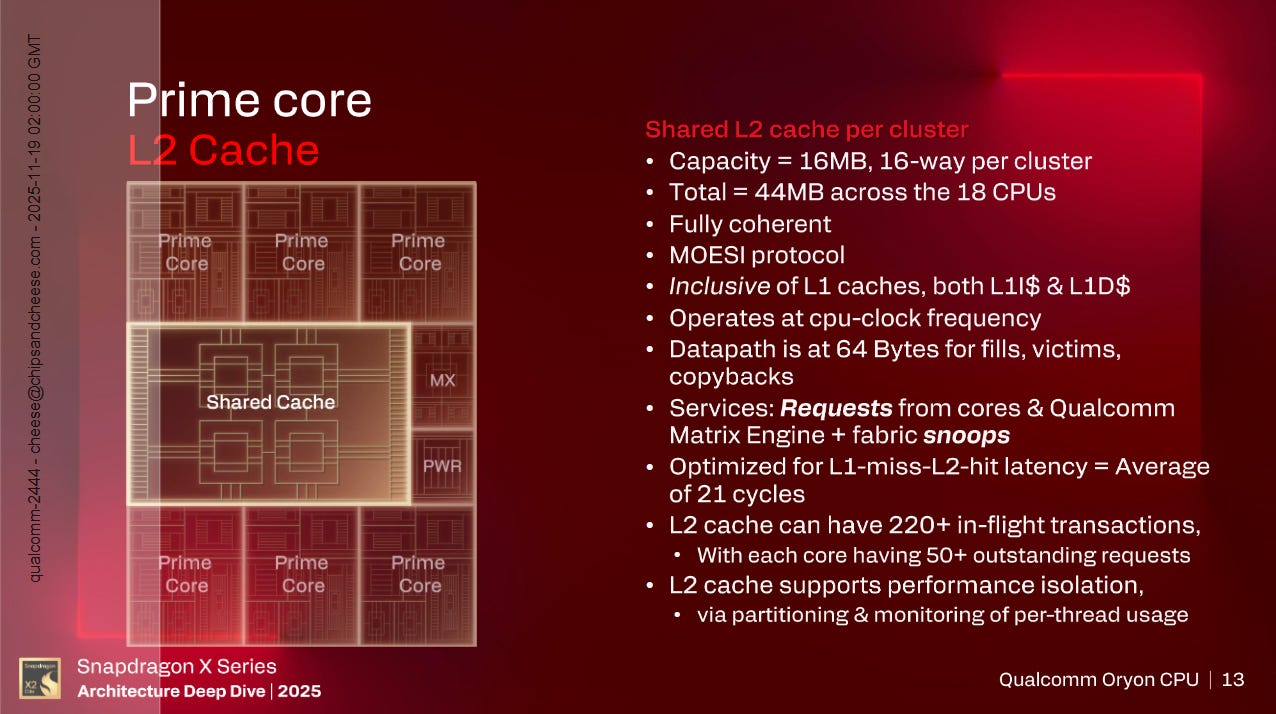
与 AMD 的 chiplet 思路类似,高通在骁龙 X2 Elite Extreme 上采用了 CPU 群集化架构,将 18 个核心划分为三个六核心群集。每个群集在系统级互连中仅作为一个客户端节点,显著减少了互连需要服务的终端数量。据 Chips and Cheese 分析,这种设计让共享缓存只需关注本群集内的核心,既简化了缓存一致性协议,也缩短了关键路径延时。
明星趣闻三个群集的划分颇具讲究:第一个群集搭载 6 个 E 核心(高通称之为“Performance”核心),共享 12 MB L2 缓存;另外两个群集各搭载 6 个 P 核心(高通称之为“Prime”核心),分别共享 16 MB L2 缓存。相比上一代骁龙 X Elite 的四核心群集,新架构在群集粒度上提升了 50%,进一步降低了互连的负载压力。
明星糗事缓存层级重构:向苹果 M1 取经的激进路线
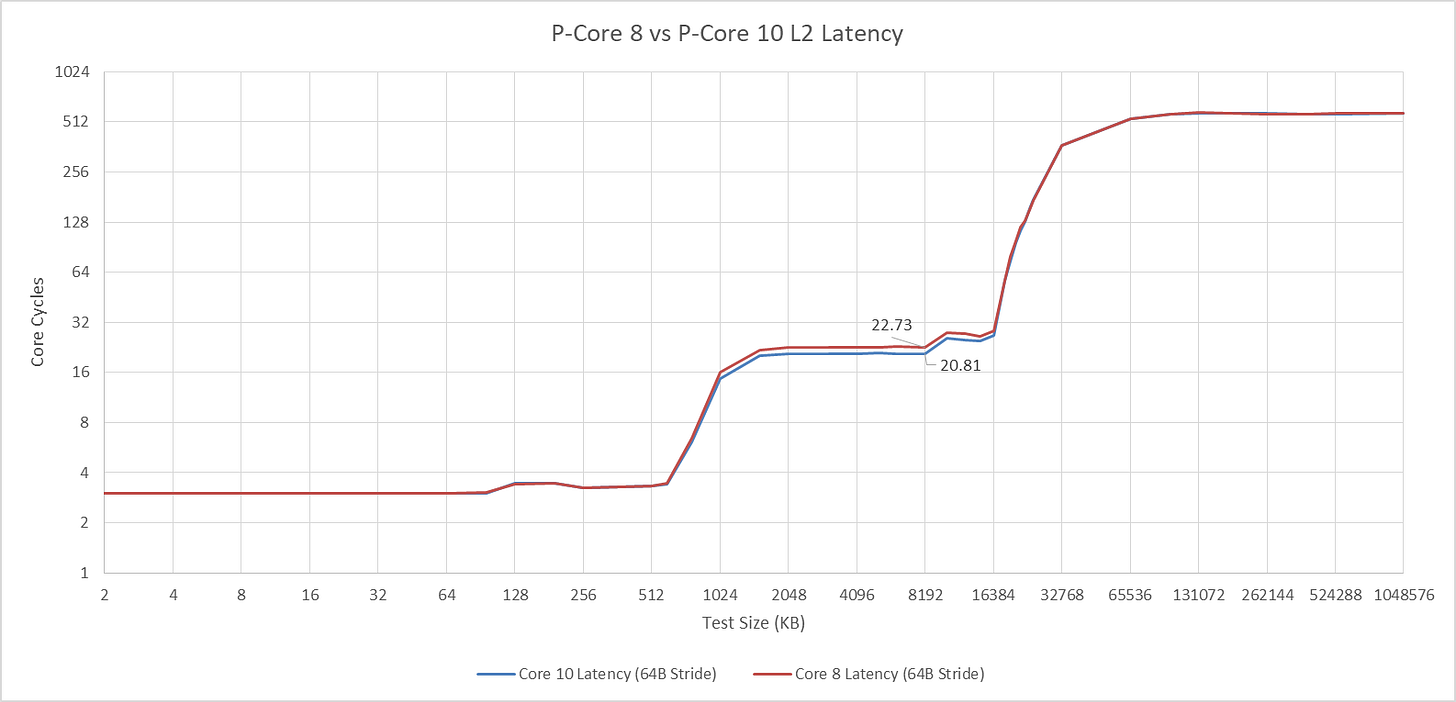
高通在缓存层级上采取了一套与苹果 M1 高度相似的策略:每个群集的 L2 缓存以核心时钟频率运行,并与核心紧密耦合,以提供极低的访问延迟和高带宽。Chips and Cheese 实测数据显示,P 核心与 E 核心群集的 L2 访问延迟均为 20-21 个周期。
明星秘闻
与此同时,每个 CPU 核心配备了相对较大的 L1 缓存,使得高通可以完全省略 AMD、Arm 和 Intel 设计中常见的中级缓存(SLC)。这种去中间层的设计,在 x86 阵营中几乎不可想象,但在高通的 ARM 架构上却实现了性能与功耗的平衡。分析人士指出,这种激进取舍意味着 L2 的命中率必须足够高,否则任何未命中都将直接落入 DRAM,造成数百周期的惩罚。
18 核心规模背后的互连带宽挑战
系统级互连面临的核心矛盾在于:核心越多,对互连带宽的需求呈指数级增长。骁龙 X2 Elite Extreme 拥有 18 个 CPU 核心,加上集成 GPU、NPU、ISP、视频编解码器等多个 IP 块,互连必须同时保证低延迟、高带宽和可扩展性。
据 Semianalysis 的研究员 Dylan Patel 透露,高通在这一代芯片中大幅扩展了片上互连的物理宽度,并优化了仲裁算法,以应对多群集并发访问内存时可能出现的拥塞。与苹果 M4 Pro 的互连设计相比,高通更强调群集级本地性——即数据优先在群集内的 L2 缓存中完成交互,而非频繁经过全局互连。
| 芯片型号 | 核心数 | 群集配置 | L2 缓存总量 | 制程工艺 |
|---|
| --- | --- | --- | --- | --- |
|---|
| 骁龙 X2 Elite Extreme | 18 | 3×6 核 | 44 MB | 台积电 N3 |
|---|
| 骁龙 X Elite | 12 | 3×4 核 | 42 MB | 台积电 4nm |
|---|
| 苹果 M4 Pro | 14 | 1×10 + 1×4 | 约 32 MB | 台积电 3nm |
|---|
| AMD Ryzen AI 9 | 12 | 2×6 核 | 24 MB | 台积电 4nm |
|---|
GPU 算力跃升:互连压制的又一座大山
骁龙 X2 Elite Extreme 的集成 GPU 是另一只吞噬带宽的巨兽。Chips and Cheese 的报告称,其 FP32 算力接近 106.5 TFLOPS,几乎逼平 NVIDIA GeForce GTX 1070 Ti(约 8.87 TFLOPS,但 X2 Elite 的指标包含稀疏计算,实际需另行折扣)。即便如此,这样的 GPU 性能在集成显卡中仍属第一梯队。
为了喂饱 GPU,高通为它分配了独立的内存访问路径,并支持 LPDDR5X-8533 内存,理论带宽可达 136.5 GB/s。Chips and Cheese 指出,若内存控制器与互连的调度策略调校不当,GPU 的带宽抢占将严重拖累 CPU 核心的访存性能。目前看来,高通通过优先级队列机制来隔离 GPU 与 CPU 的流量,具体效果有待后续基准测试验证。
与竞争对手的架构路线对比
从系统级互连的角度,高通这套方案最接近苹果 M 系列的统一内存架构,但侧重点有所不同。苹果 M1 的设计强调绝对的 L2 低延迟,而高通在此基础上更进一步,直接取消了 SLC 层。Agent Richard 指出,骁龙 X2 Elite 的每个群集 L2 容量从上一代的 12 MB 增加到 16 MB(P 核心群集),这一提升在应对 GPU 并行任务时尤为关键。
相比之下,Intel Lunar Lake 采用了一个基础 tile 加计算 tile 的分离设计,互连跨 die 实现;AMD Strix Point 则沿用 chiplet 互连,两者在跨群集通信延迟上都高于高通的单 die 集成方案。Arm 的 CMN-700 互连虽然成熟,但在 18 核规模下的功耗表现不及高通的群集式缓存方案。
功耗与能效:互连设计的天平另一端
更高的互连带宽通常意味着更高的功耗,Chips and Cheese 在报告中强调,高通通过将 L2 缓存调度到与核心同频来换取性能,但这在低频运行时会成为功耗漏点。相反,当芯片执行轻负载任务时,系统可以将部分群集完全断电,互连仅维持必要路径的供电
高通宣称骁龙 X2 Elite Extreme 的能效比上一代提升了约 30%,但这一数字仅指 CPU 部分。含 GPU 和 NPU 的整芯片功耗数据尚未公开,这将是后期评测中需要重点观察的指标。
Q1:骁龙 X2 Elite Extreme 的 L2 缓存设计为何能实现 20-21 周期的低延迟?
A1: 据 Chips and Cheese 分析,高通将 L2 缓存直接以核心时钟频率运行,并且物理上紧密耦合至核心,省去了中间缓存层级。这种设计在苹果 M1 上已被验证,代价是若 L2 命中率下降,性能衰减会非常剧烈,因此对核心的预取算法要求极高。
Q2:取消 SLC 是否会导致 GPU 与 CPU 之间的数据争抢失控?
A2: 高通并非完全取消共享缓存,而是依赖 DRAM 的高带宽和互连内的优先级队列来隔离流量。Chips and Cheese 指出,GPU 拥有独立的内存访问路径,可绕过 CPU 群集的 L2 直接访问 DRAM,因此争抢仅在读写内存控制器时发生。具体调度效果仍需实际测试确认。
站在 2026 年年中的节点回望,高通骁龙 X2 Elite Extreme 的系统级架构展现了高度的工程自信——用群集化简互连、用大 L2 换延迟,用去 SLC 赌命中率。这套设计能否在笔记本电脑市场真正撼动 Apple Silicon 与 x86 巨头,即将发布的 ASUS 等品牌实测数据将给出答案。
Market Overview
深度拆解高通骁龙 X2 Elite Extreme 的系统级架构:18 核群集设计、44MB L2 缓存、20-21 周期延迟,与苹果 M4 Pro、AMD Strix Point 全面对比。